Message broker в IT: как работают RabbitMQ, Kafka и паттерны очередей
 ноя, 8 2026
Представьте, что вы заказываете пиццу. Вы звоните в ресторан, говорите «две пепперони», и ждете. Если кухня перегружена, вам скажут перезвонить позже. А если бы существовал идеальный сервис, который принимает ваш заказ мгновенно, ставит его в очередь, уведомляет повара, когда тот освободится, и гарантирует, что ваша пицца не потеряется в хаосе? В мире Message broker - это именно такой посредник. Это программное обеспечение, которое выступает буфером между приложениями, позволяя им общаться асинхронно и без блокировок.
Если вы разработчик или архитектор, вы наверняка слышали споры о том, что лучше: RabbitMQ или Apache Kafka. Многие новички путают их, считая взаимозаменяемыми инструментами для отправки писем. На самом деле разница фундаментальна. Один оптимизирован для сложной маршрутизации задач, другой - для потоковой обработки миллионов событий в секунду. Понимание этих различий спасет вас от архитектурных катастроф на проде.
Зачем вообще нужны брокеры сообщений?
Давайте честно: можно ли обойтись без брокера? Да, если у вас монолитное приложение с одним сервером. Но как только система растет, синхронные вызовы (HTTP-запросы) становятся узким горлышком. Клиент отправляет запрос и ждет ответа. Если база данных зависла, клиент тоже висит. Если микросервис оплаты упал, пользователь видит ошибку вместо подтверждения заказа.
Брокер сообщений разрывает эту прямую связь. Отправитель пишет сообщение в очередь и сразу получает ответ «принято». Дальше получатель забирает данные, когда будет готов. Это дает три суперсилы:
- Развязка по времени: Получатель может быть недоступен, но сообщения не пропадут.
- Балансировка нагрузки: Очередь сглаживает пиковые нагрузки, не давая системе упасть от шквала запросов.
- Гарантии доставки: Вы можете настроить механизм так, чтобы сообщение было обработано ровно один раз или хотя бы один раз.
RabbitMQ: мастер маршрутизации
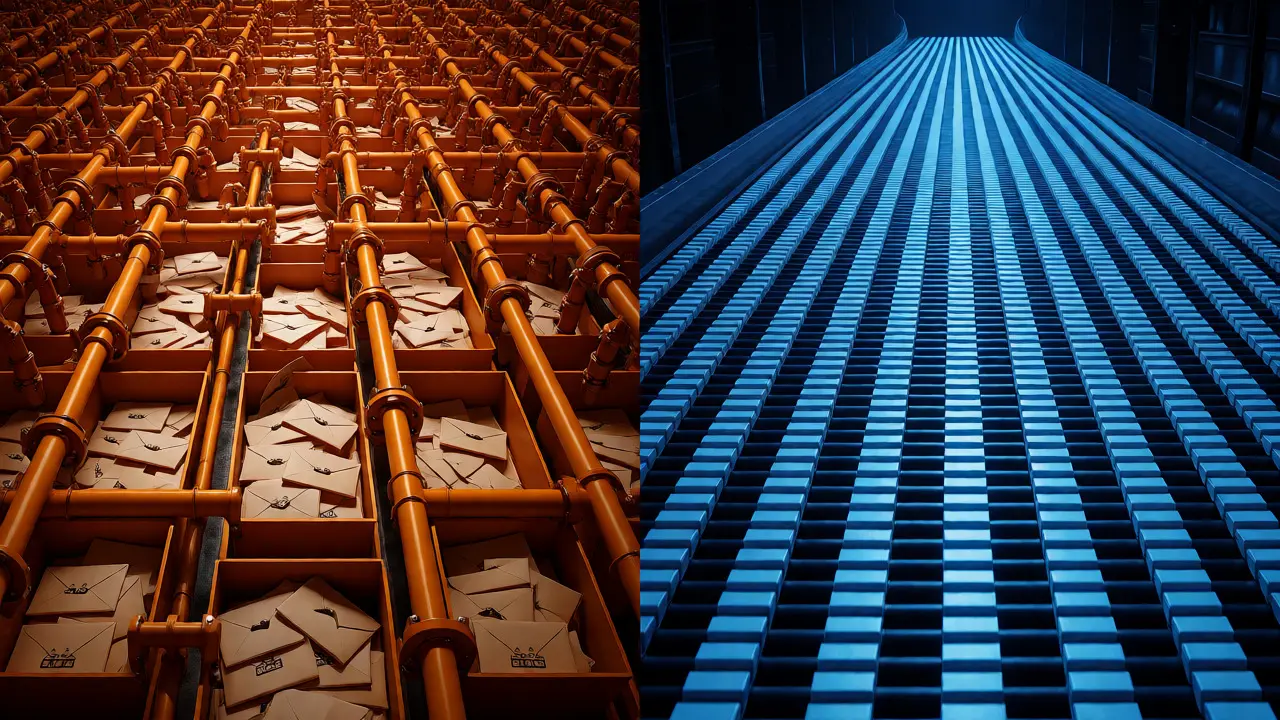
RabbitMQ - это классический брокер на базе протокола AMQP (Advanced Message Queuing Protocol). Он создан для ситуаций, где важна логика обработки отдельных задач, а не скорость потока. Представьте почтовую службу, которая читает адрес на конверте и решает, в какой ящик положить письмо.
Ключевая фишка RabbitMQ - гибкая маршрутизация через Exchange и Binding. Сообщение попадает не напрямую в очередь, а сначала на «биржу» (Exchange), которая распределяет его по очередям на основе ключей маршрутизации (Routing Key). Это позволяет строить сложные топологии: broadcast (рассылка всем), multicast (рассылка группе) или direct (точечная доставка).
Когда выбирать RabbitMQ?
- Вам нужна гарантированная доставка каждого отдельного сообщения.
- Логика обработки сложная: разные типы задач идут к разным воркерам.
- Объем трафика умеренный (тысячи сообщений в секунду).
- Требуется низкая задержка при малой нагрузке.
Однако у него есть слабое место: производительность падает при огромном количестве маленьких сообщений. Каждый акт записи на диск стоит дорого, а RabbitMQ старается сохранять каждое сообщение.
Apache Kafka: конвейер данных
Apache Kafka часто ошибочно называют просто очередью. Технически это распределенный журнал событий (distributed commit log). Здесь нет понятия «удалил сообщение после прочтения». Данные пишутся последовательно на диск и хранятся заданный срок (например, 7 дней). Потребители сами решают, откуда читать: с начала истории или с текущей позиции.
Архитектура Kafka построена вокруг тем (Topics) и партиций. Каждая тема делится на партиции для параллельной обработки. Это делает Kafka невероятно масштабируемой. Она способна обрабатывать миллионы сообщений в секунду на одном кластере, сохраняя порядок внутри партиции.
Когда выбирать Kafka?
- Вы работаете с Big Data или потоками логов.
- Нужно хранить историю событий для повторной обработки (event sourcing).
- Множество потребителей читают одни и те же данные независимо друг от друга.
- Приоритет - пропускная способность, а не минимальная задержка одного сообщения.
Минус Kafka в сложности эксплуатации. Требует ZooKeeper (или KRaft в новых версиях), мониторинга и глубокого понимания концепций offset и consumer group.
Сравнение подходов: таблица решений
Чтобы не гадать, давайте посмотрим на факты. Выбор зависит не от моды, а от бизнес-требований.
| Характеристика | RabbitMQ | Apache Kafka |
|---|---|---|
| Основная модель | Умная очередь, тупой потребитель | Тупой брокер, умный потребитель |
| Протокол | AMQP, MQTT, STOMP | Собственный TCP-протокол |
| Производительность | До 10-20k msg/sec (зависит от размера) | До 1M+ msg/sec |
| Маршрутизация | Гибкая (Headers, Topic, Direct) | Простая (по ключу партиции) |
| Хранение | Удаление после подтверждения (ACK) | Хранение до истечения TTL |
| Идеальный кейс | Фоновые задачи, email, уведомления | Логи, метрики, стриминг, CQRS |
Паттерны очередей, которые спасут вашу архитектуру
Выбрать инструмент мало. Нужно знать, как с ним работать, чтобы не создать distributed monolith. Вот основные паттерны, которые используют инженеры каждый день.
Competing Consumers (Конкурирующие потребители)
Это базовый паттерн масштабирования. Одна очередь, много воркеров. Брокер раздает сообщения разным процессам, обеспечивая балансировку нагрузки. Если один воркер упал, остальные подхватят работу. Работает отлично и в RabbitMQ, и в Kafka (через Consumer Groups).
Request-Reply (Запрос-Ответ)
Асинхронный аналог HTTP GET. Клиент отправляет сообщение с уникальным ID и временным адресом ответа. Сервер обрабатывает задачу и публикует результат в указанную очередь. Полезно, когда операция долгая (генерация PDF, экспорт отчетов), но клиент хочет получить финальный статус.
Publish-Subscribe (Pub/Sub)
Один издатель, множество подписчиков. Классика для событийных систем. Например, событие «UserRegistered» публикуется в топик. Сервис рассылок, аналитика и CRM независимо получают копию этого события. В RabbitMQ это реализуется через Fanout Exchange, в Kafka - через создание разных Consumer Groups для одной темы.
Dead Letter Queue (Очередь мертвых писем)
Что делать, если сообщение не удалось обработать? Не выбрасывать! Переместить его в DLQ. Это критически важно для отладки. Вы сможете изучить причину падения, исправить баг и переотправить сообщение вручную. Без DLQ вы теряете данные при сбоях.
Типичные ошибки новичков
Я видел много проектов, где брокеры использовались неправильно. Самая частая ошибка - попытка использовать Kafka как замену Redis для кэширования или RabbitMQ для хранения архива логов. Вторая беда - игнорирование идемпотентности. В распределенных системах сообщения могут дублироваться (at-least-once delivery). Ваш код должен корректно обрабатывать повторную доставку одного и того же платежа, не списывая деньги дважды.
Еще одна ловушка - слишком большие сообщения. Передача видеофайла целиком через брокер убьет производительность. Лучше передавать ссылку на файл в объектном хранилище (S3), а сам файл грузить отдельно.
Практические советы по внедрению
Если вы только начинаете путь с брокерами, следуйте этим правилам:
- Начните с простого. Если у вас стартап с 100 пользователями, возможно, вам хватит PostgreSQL LISTEN/NOTIFY или простой таблицы в БД. Брокер нужен, когда нагрузка растет.
- Мониторьте лаг (Lag). Для Kafka это расстояние между последней написанной и последней прочитанной позицией. Растущий лаг означает, что потребители не справляются. Время бить тревогу.
- Используйте Prefetch Count. В RabbitMQ этот параметр ограничивает количество необработанных сообщений, доставленных одному воркеру. Это предотвращает ситуацию, когда один быстрый воркер забирает все задачи, а медленные простаивают.
- Проектируйте схемы сообщений. Используйте Avro или Protobuf для сериализации. JSON удобен для чтения человеком, но тяжел для парсинга и занимает больше места.
FAQ: Частые вопросы о брокерах сообщений
Можно ли заменить RabbitMQ на Kafka?
Не всегда. Kafka плохо подходит для задач, требующих сложной маршрутизации отдельных сообщений или гарантированной доставки с подтверждением каждой единицы. Если вам нужно просто складывать логи в базу - берите Kafka. Если нужно рассылать уведомления с разными приоритетами - лучше RabbitMQ.
Что такое идемпотентность потребителя?
Это свойство системы, при котором многократное выполнение одной операции дает тот же результат, что и однократное. Поскольку брокеры могут доставить одно сообщение дважды (из-за сетевых сбоев), ваш код должен проверять, был ли уже обработан конкретный ID заказа, прежде чем менять статус в базе.
Как обеспечить порядок сообщений в Kafka?
Kafka гарантирует порядок только внутри одной партиции. Чтобы сохранить глобальный порядок для конкретного пользователя, используйте его User ID как ключ партиции. Тогда все события этого пользователя попадут в одну партицию и будут обработаны строго последовательно.
Что тяжелее администрировать: RabbitMQ или Kafka?
RabbitMQ проще в развертывании и настройке для небольших команд. Kafka требует больше ресурсов и знаний для управления кластером, репликацией и шардированием. Однако облачные версии (AWS MSK, Confluent Cloud) сильно упрощают жизнь с Kafka.
Нужен ли брокер для микросервисов?
Да, практически всегда. Микросервисы должны быть слабо связанными. Синхронные вызовы создают жесткую зависимость от доступности соседей. Брокер позволяет сервисам жить своей жизнью, накапливая события, даже если другие части системы временно недоступны.