Логирование приложений: ELK-стек и современные альтернативы для разработчиков
 ноя, 15 2026
Помните тот кошмарный момент в пятницу вечером, когда продакшн лежит, а вы сидите перед консолью с командой grep, пытаясь понять, где именно всё сломалось? Если да, то вы уже знаете цену правильному логированию приложений. Просто писать сообщения в файл недостаточно. Нам нужна система, которая собирает, индексирует и позволяет мгновенно искать нужные строки среди миллионов записей.
Долгое время золотым стандартом был ELK-стек: Elasticsearch, Logstash и Kibana. Но мир DevOps не стоит на месте. Сегодня у нас есть более легкие, дешевые и иногда даже эффективные альтернативы. Давайте разберемся, что выбрать в 2026 году, чтобы не сойти с ума от стоимости облачных сервисов и сложности поддержки.
Зачем вообще нужен централизованный сбор логов
Раньше, когда приложение работало на одном сервере, можно было просто открыть файл /var/log/app.log. Сейчас микросервисная архитектура означает десятки или сотни контейнеров, которые живут и умирают каждую минуту. Логи из них разбросаны по разным узлам кластера Kubernetes. Без централизованного решения вы просто потеряете контекст.
Централизованное логирование решает три главные задачи:
- Поиск и фильтрация: Вы можете найти все ошибки с кодом 500 за последние 15 минут, связанные с конкретным ID пользователя.
- Корреляция событий: Понять, как запрос прошел через цепочку микросервисов (трейсинг).
- Алертинг: Автоматически получать уведомление, если количество ошибок резко выросло.
Классика жанра: ELK-стек
Elasticsearch - это поисковый движок, который является сердцем системы. Он хранит данные в формате JSON и позволяет делать сложные запросы почти мгновенно. Однако за скорость приходится платить памятью и дисковым пространством.
Logstash выступает в роли трубопровода. Он собирает данные из разных источников, парсит их, преобразует формат и отправляет в Elasticsearch. Проблема Logstash в том, что он написан на Java и потребляет много ресурсов процессора и памяти.
Kibana - это визуальный интерфейс. Здесь вы строите дашборды, создаете графики активности и анализируете тренды. Это самый удобный способ взаимодействия с данными для людей, которые не любят писать сложные запросы к базе данных.
| Компонент | Роль в системе | Основные недостатки |
|---|---|---|
| Elasticsearch | Хранение и индексация логов | Высокое потребление RAM, дорогое хранение холодных данных |
| Logstash | Сбор и обработка данных | Тяжелый агент, сложная конфигурация пайплайнов |
| Kibana | Визуализация и поиск | Медленная работа при огромных объемах данных без тюнинга |
ELK отлично подходит, если вам нужен полный текстовый поиск по всем полям логов. Но если бюджет ограничен, а логи нужны только для поиска ошибок, этот стек может оказаться избыточным.
Эволюция: EFK и Fluentd
Многие команды заменяют тяжелый Logstash на Fluentd или его легковесную версию Fluent Bit. Эта связка называется EFK (Elasticsearch, Fluentd, Kibana).
Fluentd написан на Ruby (или Go в случае Fluent Bit), что делает его значительно легче. Он лучше интегрируется с Docker и Kubernetes благодаря встроенным плагинам. Fluent Bit особенно хорош для edge-вычислений или высоконагруженных узлов, где каждый мегабайт оперативной памяти на счету.
Новая волна: Grafana Loki
Если вы уже используете Prometheus для метрик, то Grafana Loki станет для вас спасением. Главный принцип Loki: "Индексируй только метаданные, а не сам текст".
В отличие от Elasticsearch, Loki не индексирует содержимое каждого слова в логе. Он индексирует только лейблы (например, app=backend, env=prod). Когда вы делаете запрос, система находит файлы с нужными лейблами и сканирует их содержимое напрямую (graceful grep). Это радикально снижает стоимость хранения и требует меньше ресурсов.
Loki идеально работает в связке с Promtail (агент сбора) и Grafana (визуализация). Для большинства проектов среднего размера это лучший выбор по соотношению цена/производительность.
Стандарт де-факто: OpenTelemetry
Неважно, какой бэкенд вы выберете - Elasticsearch, Loki или Datadog. Вам нужно правильно собирать данные. Здесь на сцену выходит OpenTelemetry (OTel).
Это набор инструментов для генерации, сбора и экспорта телеметрических данных. OTel объединяет логи, трейсы и метрики в единую экосистему. Вместо того чтобы внедрять специфичные агенты для каждой системы мониторинга, вы пишете код один раз с использованием SDK OpenTelemetry, а затем переключаете экспорт в любой поддерживаемый бэкенд.
Использование OTel защищает вас от vendor lock-in. Завтра вы решите перейти с ELK на Grafana Cloud - вам не придется переписывать весь код приложения, достаточно будет изменить конфигурацию collector'а.
Как выбрать решение под свои задачи
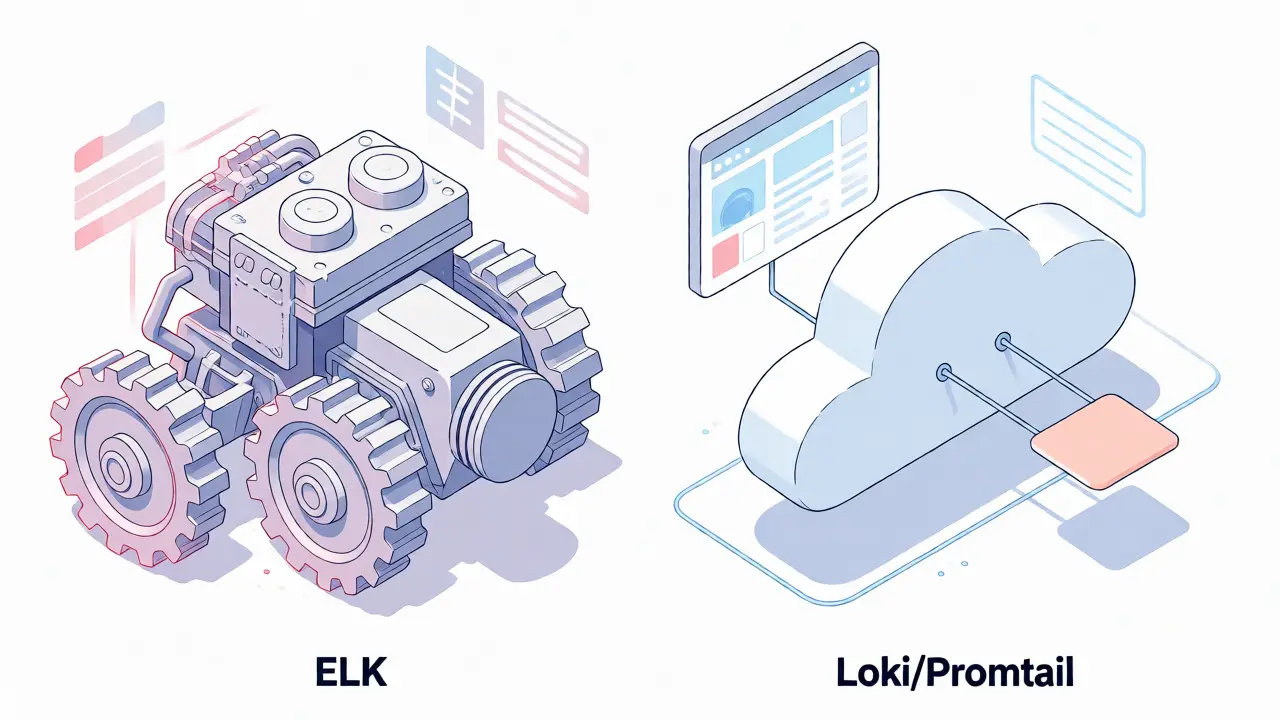
Выбор инструмента зависит от трех факторов: объем данных, требуемая глубина анализа и бюджет.
- Нужен полнотекстовый поиск? Если аналитики часто ищут конкретные фразы внутри сообщений об ошибках, выбирайте Elasticsearch или OpenSearch (форк Elastic без ограничений лицензии).
- Логи нужны только инженерам для отладки? Grafana Loki справится отлично. Он дешевле и проще в эксплуатации.
- Нет времени на поддержку инфраструктуры? Рассмотрите управляемые сервисы: Datadog, Splunk или Grafana Cloud. Они дороже, но экономят время команды.
Для стартапов и небольших компаний я обычно рекомендую начинать с Grafana Loki + Promtail. Это дешево, быстро стартует и масштабируется до разумных пределов. Когда проект вырастет и появятся требования к сложной аналитике, можно будет мигрировать на OpenSearch или платные решения.
Практические советы по настройке
Даже самая крутая система бесполезна, если логи настроены неправильно. Вот несколько правил, которые сэкономят вам нервы:
- Структурируйте логи. Не пишите "User login failed for user 123". Лучше отправить JSON:
{"level": "error", "message": "login_failed", "user_id": 123}. Так вы сможете фильтровать по полюuser_idилиmessageбез регулярных выражений. - Учитывайте уровень детализации. В продакшене не стоит логировать каждый шаг цикла. Оставьте DEBUG-логи только для тестовых стендов. В проде используйте INFO, WARN и ERROR.
- Настройте ротацию и TTL. Хранить все логи вечно бессмысленно. Настройте удаление старых данных (Time-To-Live) после 7-30 дней, в зависимости от требований безопасности.
- Будьте осторожны с PII. Персональные данные (пароли, номера карт) не должны попадать в логи. Используйте маскирование на этапе сбора (в Logstash или Fluentd).
Часто задаваемые вопросы
Что такое ELK-стек простыми словами?
ELK-стек - это набор из трех программ: Elasticsearch (хранит и ищет данные), Logstash (собирает и обрабатывает данные) и Kibana (показывает красивые графики). Вместе они позволяют разработчикам видеть, что происходит внутри их приложений в реальном времени.
Чем Grafana Loki отличается от Elasticsearch?
Главное отличие в индексации. Elasticsearch индексирует каждое слово в логах, что делает поиск быстрым, но хранение дорогим. Loki индексирует только метаданные (лейблы), а текст логов хранится в сжатом виде без полного индекса. Это делает Loki значительно дешевле и легче в обслуживании, но поиск по тексту может быть чуть медленнее при очень больших объемах.
Нужен ли мне OpenTelemetry, если я использую ELK?
Да, OpenTelemetry полезен всегда. Он стандартизирует способ отправки логов из вашего кода. Если завтра вы захотите сменить бэкенд с Elasticsearch на Loki или Datadog, вам не придется менять код приложения - только конфигурацию агента. Это защита от привязки к одному вендору.
Какой агент лучше: Filebeat, Fluentd или Promtail?
Filebeat создан специально для Elasticsearch и очень легкий. Fluentd универсален и гибок, но тяжелее. Promtail оптимизирован для работы с Loki и Kubernetes. Если вы используете Loki, берите Promtail. Если Elasticsearch - Filebeat. Для смешанных архитектур и сложных маршрутизаций подойдет Fluentd.
Сколько стоит поддержка собственного ELK-кластера?
Стоимость складывается из двух частей: инфраструктура (серверы, диски SSD, память) и время инженеров на поддержку. Elasticsearch требует много RAM (минимум 8-16 ГБ на ноду для нормальной работы). Часто аренда готового сервиса (как AWS OpenSearch или Elastic Cloud) оказывается дешевле, чем содержать команду, которая будет чинить падающие ноды Elasticsearch.